robots.txt et sitemap.xml : le socle technique, et les erreurs qui coûtent du trafic


Le robots.txt et le sitemap.xml sont les deux fichiers les plus simples d'un site, et ceux qu'on ne regarde plus une fois en place. C'est précisément ce qui les rend dangereux : une ligne héritée de la préproduction ou un sitemap qui répond mal suffisent à couper l'exploration sans que rien ne casse à l'écran. En préparant cet article, mon diagnostic SEO a d'ailleurs signalé un problème sur mon propre sitemap, que j'ai corrigé depuis. Voici le fichier minimal à copier, les erreurs qui comptent vraiment, et ce cas réel avec sa correction.
Un robots.txt minimal, ligne par ligne, sur mon propre site
Le 9 octobre, le fichier que je servais en production tenait en quatre lignes utiles.
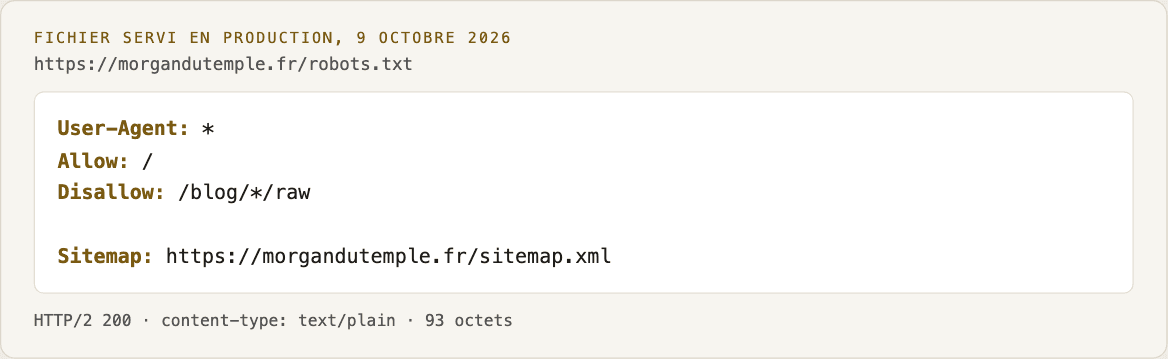
Tout était autorisé pour tous les robots, sauf les versions Markdown brutes de mes articles (/blog/<slug>/raw), et l'adresse du sitemap était déclarée en URL complète. Depuis le 16 octobre, le fichier n'en compte plus que trois : la ligne Disallow a disparu, pour une raison que j'explique plus bas. Pour la plupart des sites vitrines, c'est tout ce qu'il faut :
User-agent: *
Allow: /
Disallow: /recherche

Sitemap: https://www.example.com/sitemap.xml
La ligne Disallow: /recherche est un exemple : on n'y met que des zones sans intérêt pour un moteur (pages de recherche interne, back-office). Les règles propres aux crawlers IA (GPTBot, ClaudeBot, OAI-SearchBot) sont un autre sujet, que j'ai traité dans mon article sur ce qu'il faut réellement configurer pour les crawlers IA.
Ce Disallow illustrait aussi la limite la plus mal comprise du fichier. Google le dit sans détour : le robots.txt sert à gérer le trafic des robots, ce n'est pas un moyen de garder une page hors de Google. Mes pages /raw sont listées dans mon llms.txt ; Google pouvait donc connaître leur adresse et l'afficher sans description, même sans les explorer. Et pour les désindexer par un noindex, il fallait d'abord lever le blocage : Google précise qu'une page bloquée par le robots.txt ne peut pas lui montrer sa balise noindex. C'est ce que j'ai fait le 16 octobre : le Disallow est retiré, et ces versions Markdown répondent désormais avec l'en-tête HTTP X-Robots-Tag: noindex et une canonical vers l'article HTML, que les robots peuvent enfin lire.
Les erreurs de robots.txt qui coupent réellement l'exploration
La plus brutale reste le Disallow: / sous User-agent: *, copié depuis un environnement de préproduction et jamais retiré à la mise en ligne. Il interdit tout le site. Le diagnostic le repère et l'affiche en rouge.
Moins connue, la réponse HTTP du fichier compte autant que son contenu. D'après la spécification de Google, un fichier en 404 (ou toute erreur 4xx sauf 429) équivaut à l'absence de restriction : le site reste explorable. Une erreur serveur 5xx, en revanche, fait suspendre l'exploration pendant 12 heures, puis Google se rabat sur la dernière version valide en cache pendant 30 jours. Un robots.txt qui plante coûte donc bien plus cher qu'un robots.txt absent.
Trois détails complètent le tableau. Le fichier ne vaut que pour le protocole, l'hôte et le port où il est publié : un sous-domaine blog. a besoin du sien. Google ignore ce qui dépasse 500 Kio. Et il garde le fichier en cache jusqu'à 24 heures en général, une correction n'est donc pas prise en compte instantanément. Les redirections, elles, ne posent pas de problème tant qu'elles restent courtes : www.morgandutemple.fr/robots.txt répond par une seule redirection 308 vers le domaine nu, quand Google en suit au moins cinq.
Sitemap XML : format, déclaration et ce que Google ignore
Un sitemap est limité à 50 000 URL ou 50 Mo non compressés ; au-delà, on le découpe avec un fichier d'index. Les URL doivent être absolues, et le protocole sitemaps.org impose qu'elles appartiennent toutes à l'hôte du fichier, sauf soumission croisée déclarée dans le robots.txt de l'autre hôte. On le déclare de deux façons, cumulables : la ligne Sitemap: du robots.txt et le rapport Sitemaps de Search Console.
Sur les balises, la documentation est nette : Google utilise <lastmod> seulement si la date est fiable, et ignore <priority> et <changefreq>. Mon sitemap en est la démonstration involontaire : le 26 octobre, ses 405 URL portaient toutes changefreq et priority, que mon code de génération renseigne pour rien, et seules 172 d'entre elles (les articles, en français et en anglais) avaient un lastmod, qui reprend la date de publication et non celle de la dernière modification. Rien de bloquant, mais pas un signal non plus.
Deux nuances évitent de surinvestir. Google estime qu'un site d'environ 500 pages ou moins, ou dont toutes les pages importantes sont accessibles par des liens depuis l'accueil, n'a pas forcément besoin de sitemap. Et un sitemap ne garantit ni l'exploration ni l'indexation : c'est un indice. Il ne remplace pas les liens internes, dont j'ai expliqué le rôle dans le maillage interne et le GEO.
Sitemap inaccessible : le cas réel de mon propre site
Le 9 octobre 2026, j'ai lancé mon diagnostic SEO gratuit sur ma page d'accueil. Robots.txt accessible, mais sitemap en rouge.
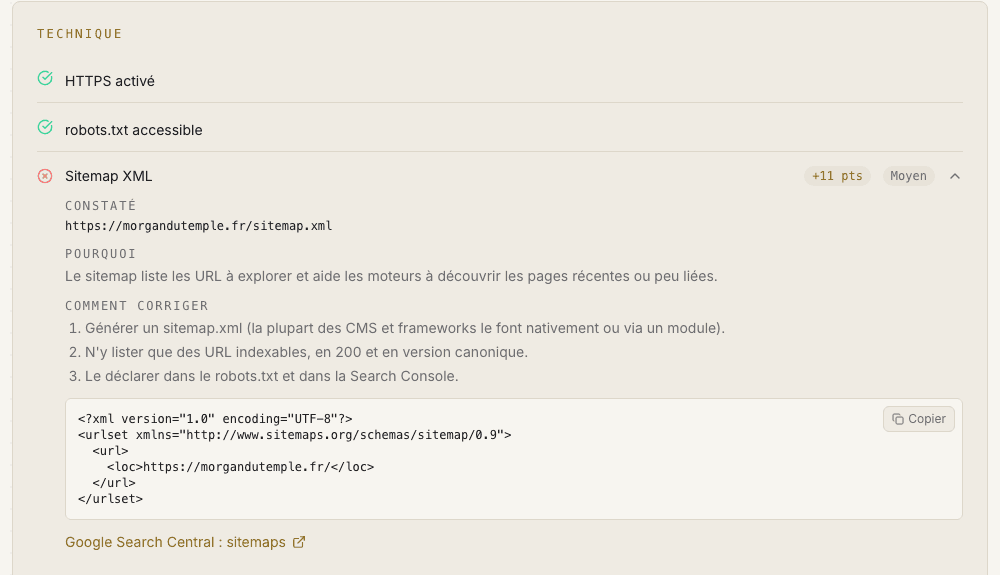
Le fichier existait pourtant. J'ai mesuré : un premier appel est resté sans réponse au bout de 20 secondes, les suivants ont répondu en 2,9 puis 0,5 seconde. Mon sitemap était généré à la demande à partir de plusieurs requêtes vers Notion, et la première génération après un délai sans visite était lente. L'outil, lui, abandonne au bout de 5 secondes. Google ne publie pas de délai d'attente pour les sitemaps, je ne prétends donc pas que Googlebot a échoué ; le seul endroit qui le dirait est le rapport Sitemaps de Search Console. Mais un fichier qui met 20 secondes à répondre est un fichier fragile, et le correctif est connu : le générer à l'avance ou le mettre en cache. C'est ce que j'ai fait : le sitemap est désormais régénéré au plus une fois par heure et servi depuis le cache de Vercel. Le 26 octobre, quatre appels successifs ont répondu entre 0,1 et 0,4 seconde, et le même diagnostic relancé sur ma page d'accueil affiche le sitemap comme accessible.
Les autres erreurs courantes portent sur le contenu. Un sitemap ne devrait lister que des URL que l'on veut voir dans Google, donc en 200, indexables et canoniques : pas de pages en noindex, pas de redirections, pas d'URL d'un autre domaine sans soumission croisée. Mes pages de tag (/blog?tag=SEO%2FGEO) y figurent avec une canonical vers elles-mêmes : c'est cohérent, même si leur intérêt dans les résultats se discute.
Ce que le diagnostic contrôle, et ce qui reste à vérifier à la main
L'outil reste volontairement simple, et autant savoir où s'arrête son regard.
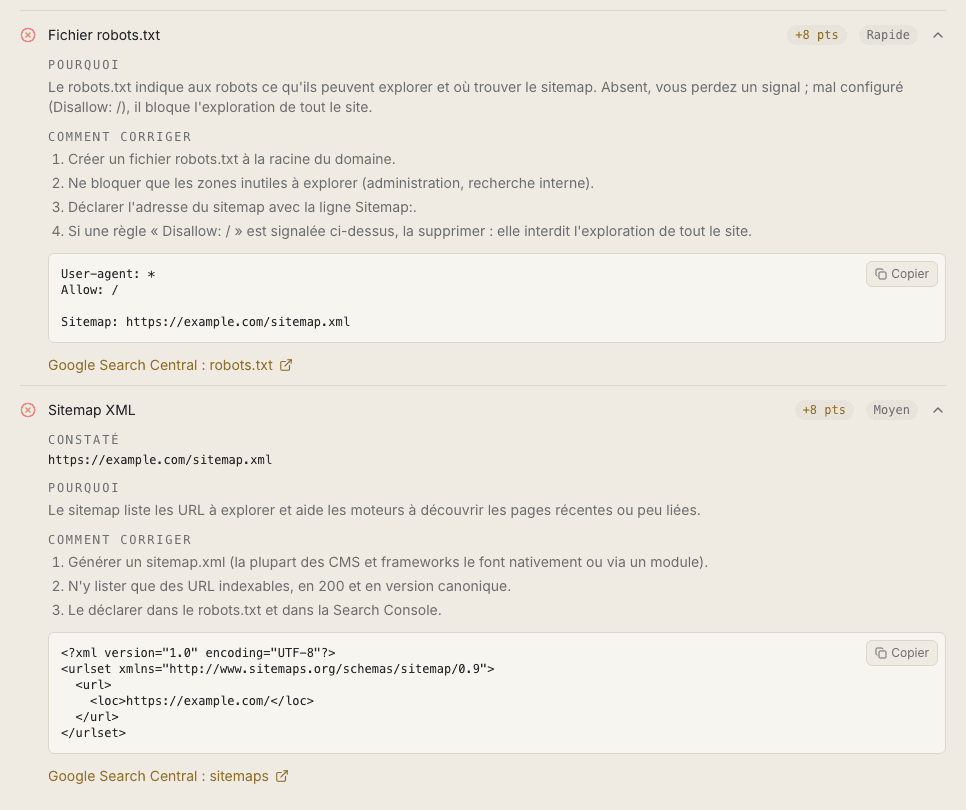
Côté robots.txt, il vérifie que le fichier répond et n'est pas vide, et détecte un Disallow: / sous User-agent: *. Un blocage ciblé sur Googlebot seul lui échappe. Côté sitemap, il teste l'adresse déclarée dans le robots.txt, puis /sitemap.xml et /sitemap_index.xml, et se contente d'un code 200 : il ne lit pas les URL listées. Pour le contenu du sitemap, les codes de réponse et la cohérence avec les canonicals, il faut ouvrir le fichier, ou faire une revue complète du site. C'est aussi par là que commence mon travail sur le GEO : un moteur génératif ne cite pas une page que les robots n'ont pas pu lire.
Sources : Google Search Central, introduction au robots.txt ; Google Search Central, interprétation de la spécification robots.txt ; Google Search Central, créer un robots.txt ; Google Search Central, présentation des sitemaps ; Google Search Central, créer et envoyer un sitemap ; Google Search Central, bloquer l'indexation avec noindex ; sitemaps.org, protocole ; mesures sur ce site (robots.txt, sitemap.xml et temps de réponse, 9 et 26 octobre 2026).
Pour aller plus loin : Bloquer ou laisser passer les crawlers IA : l'arbitrage économique de chaque éditeur, Mesurer sa visibilité GEO : ce que Google Search Console peut (et ne peut pas) vous dire
Questions fréquentes
Un site sans robots.txt est-il pénalisé par Google ?
Non. Un fichier absent (404) équivaut pour Google à une exploration sans restriction. Le diagnostic le compte quand même comme un échec, parce que vous perdez l'endroit le plus simple pour déclarer votre sitemap. Le vrai danger est un fichier qui répond en erreur 5xx.
Faut-il bloquer une page dans le robots.txt pour la retirer de Google ?
Non. Le robots.txt empêche l'exploration, pas l'indexation : une page bloquée mais liée ailleurs peut apparaître sans description. Pour la retirer, utilisez une balise noindex sur une page laissée explorable, ou une protection par mot de passe.
Les balises priority et changefreq du sitemap servent-elles à quelque chose ?
Pas pour Google, qui indique les ignorer. Seule `lastmod` est utilisée, et uniquement si elle reflète la vraie date de dernière modification de la page.
Découvre mes outils
À propos de l'auteur
Delivery Manager à Rennes. Je pilote des projets de transformation digitale, SEO/GEO et accessibilité RGAA pour des clients grands comptes. Ce blog est le reflet de ce que je rencontre sur le terrain.