Harness IA : pourquoi il compte plus que le modèle qu'il pilote


Un agent de code n'est pas un modèle de langage seul. C'est un modèle enfermé dans un harness, le système qui lui donne des outils, une mémoire, une boucle d'exécution, et des règles sur ce qu'il a le droit de faire sans validation humaine. Deux équipes peuvent utiliser exactement le même modèle sous-jacent et obtenir des niveaux de risque radicalement différents, simplement parce que leur harness ne gouverne pas de la même façon. Ce guide explique ce qu'est un harness IA, compare les deux architectures dominantes en 2026, et détaille pas à pas comment en choisir et en configurer un pour une équipe.
Qu'est-ce qu'un harness IA, concrètement ?
Un modèle de langage seul ne fait qu'une chose : transformer du texte en entrée en texte en sortie. Il ne peut ni lire un fichier, ni exécuter une commande, ni se souvenir de ce qu'il a fait il y a dix minutes. Le harness est le programme qui l'entoure et qui rend tout cela possible, en répétant une boucle en quatre temps à chaque tour.
La perception, d'abord : le harness décide ce que le modèle voit du système de fichiers, du terminal, ou des résultats d'un outil déjà appelé. La planification ensuite : le modèle propose la prochaine action à partir de ce contexte. L'exécution : le harness reçoit cette proposition et décide s'il l'exécute telle quelle, s'il la bloque, ou s'il demande une validation humaine. La mémoire enfin : le harness conserve ce qui doit être gardé d'un tour à l'autre, pour que l'agent ne reparte pas de zéro à chaque message.
Sans harness, un modèle ne peut que produire du texte. Avec un harness, ce texte devient des commandes shell réellement exécutées, des fichiers réellement modifiés, des requêtes réseau réellement envoyées. C'est cette couche, pas le modèle, qui détermine si un agent peut supprimer un fichier de production par erreur, faire sortir des données vers l'extérieur, ou s'arrêter proprement quand une tâche part dans la mauvaise direction. Claude Code, Codex, Cursor ou Aider sont des harnesses : ils peuvent tous piloter plusieurs modèles différents, et c'est précisément ce qui les distingue d'un simple modèle.
Comparatif : les harnesses IA les plus utilisés en 2026
| Harness | Éditeur | Licence | Où s'applique le contrôle | Modèles supportés | Cas d'usage recommandé |
|---|---|---|---|---|---|
| Claude Code | Anthropic | Propriétaire (CLI gratuite avec compte) | Application, via hooks programmables | Claude (natif), autres via proxy | Équipes qui veulent une politique de permissions finement personnalisée |
| Codex | OpenAI | Open source (Apache 2.0) | Système d'exploitation, sandboxing natif | GPT (natif), autres via config | Équipes qui veulent une garantie technique dure par défaut, sans écrire de règles |
| Cursor (agent mode) | Anysphere | Propriétaire | Application, dans l'éditeur | Multi-modèles (Claude, GPT, Gemini) | Développeurs qui travaillent déjà dans un IDE dédié plutôt qu'au terminal |
| Aider | Communauté open source | Open source (Apache 2.0) | Application, minimal | Multi-modèles via API | Usage individuel, scripts simples, pas de politique de gouvernance intégrée |
Ce tableau ne classe pas ces outils du meilleur au pire : il classe où se situe la responsabilité de la sécurité dans chacun. Les deux prochaines sections détaillent les deux architectures les plus utilisées en contexte professionnel, Claude Code et Codex, parce qu'elles illustrent les deux philosophies opposées qui existent aujourd'hui.
Claude Code : la gouvernance dans l'application
Claude Code applique sa politique dans le harness lui-même, via un système de hooks : des commandes shell que vous écrivez et qui s'exécutent à des points fixes du cycle de vie de la session. La documentation officielle recense 31 événements de ce type, répartis en trois cadences : une fois par session (démarrage, fin), une fois par tour de conversation, et à chaque appel d'outil dans la boucle agentique, avant son exécution (PreToolUse) et après (PostToolUse).
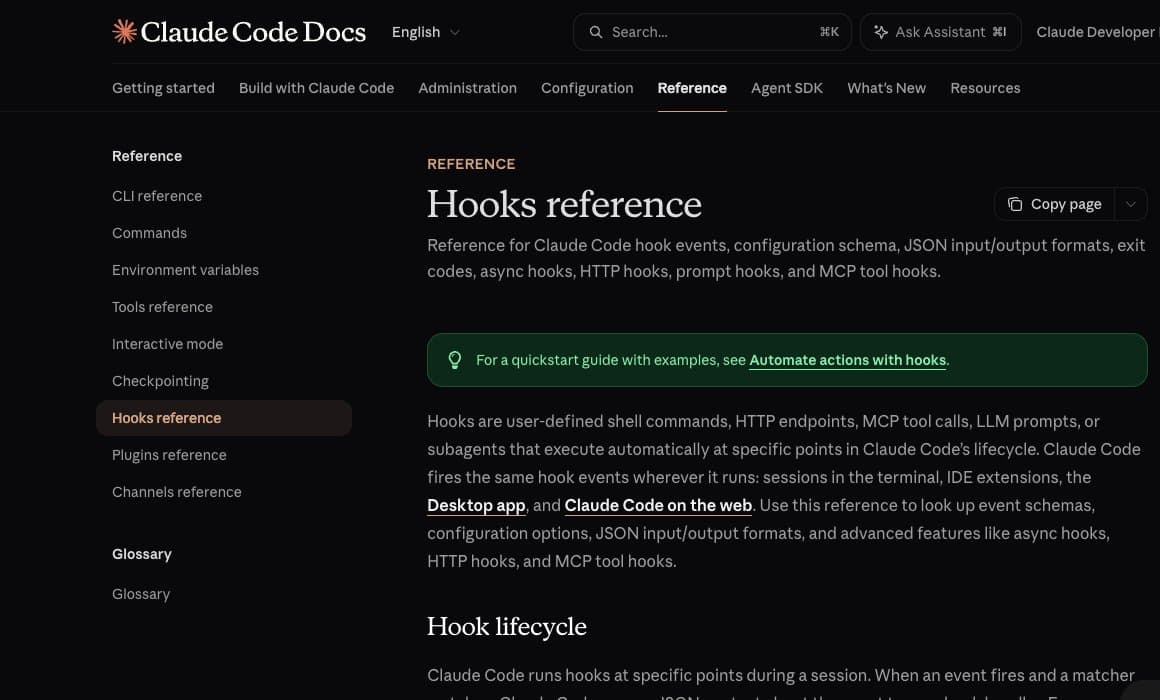
La référence officielle des hooks Claude Code, code.claude.com/docs.
Un hook reçoit les informations de l'appel en cours au format JSON, et répond par un code de sortie : 0 pour laisser passer, 2 pour bloquer l'action et renvoyer une explication au modèle, 1 pour un échec neutre qui ne bloque rien. Voici un exemple concret, un hook PreToolUse qui bloque toute commande shell contenant rm -rf ou DROP TABLE avant qu'elle ne s'exécute :
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "echo \"$CLAUDE_TOOL_INPUT\" | grep -qE 'rm -rf|DROP TABLE' && exit 2 || exit 0"
          }
        ]
      }
    ]
  }
}
Ce fichier se place dans .claude/settings.json à la racine du dépôt, pour que la règle soit versionnée avec le code et voyage avec le reste de l'équipe. Le système de permissions évalue les règles de refus en priorité : rendre un fichier sensible invisible via une règle deny est plus sûr que de compter sur un hook pour le bloquer après coup, et un hook ne peut jamais assouplir une règle de refus déjà définie dans les paramètres, seulement la durcir davantage.
Cette architecture donne une flexibilité totale : n'importe quelle règle métier, aussi spécifique soit-elle, peut être encodée dans un hook. Elle a une contrepartie directe : un hook s'exécute avec les permissions de votre propre utilisateur système, comme n'importe quelle commande shell. La sécurité tient entièrement à la qualité des règles écrites, pas à une contrainte physique du système.
Codex : la gouvernance dans le système d'exploitation
Codex, le harness open source d'OpenAI sous licence Apache 2.0, place le contrôle un cran plus bas : au niveau du système d'exploitation plutôt que de l'application. Chaque commande s'exécute dans un bac à sable natif selon la plateforme (Seatbelt sur macOS, Bubblewrap et Landlock sur Linux, jetons restreints sur Windows), avec l'accès réseau désactivé par défaut et les opérations sur fichiers cantonnées à un périmètre défini.
La configuration se fait dans ~/.codex/config.toml. Voici un exemple qui autorise Codex à lire et modifier deux dossiers précis d'un projet, sans accès réseau, en demandant une validation seulement quand une action sort de ce périmètre :
model = "gpt-5-codex"
sandbox_mode = "workspace-write"
approval_policy = "on-request"

[sandbox_workspace_write]
network_access = false
writable_roots = [
  "/chemin/vers/mon-projet/src",
  "/chemin/vers/mon-projet/tests",
]

[[rules]]
prefix = "npm test"
allow = true

[[rules]]
prefix = "docker"
allow = false
La différence avec un hook Claude Code n'est pas cosmétique. Un bac à sable Codex applique une contrainte au niveau du noyau : même une commande que le harness n'a pas explicitement anticipée dans ses règles reste bridée par ce que le système d'exploitation autorise physiquement. C'est une garantie plus dure par défaut, au prix d'une personnalisation plus contrainte que le système de hooks de Claude Code.
Tuto : comment choisir et configurer un harness pour votre équipe
Voici la démarche que je recommande, dans l'ordre, avant de généraliser un harness d'agent de code à une équipe entière.
Étape 1, cartographier ce que l'agent doit pouvoir toucher. Listez les dossiers, bases de données et services externes auxquels l'agent aura effectivement besoin d'accéder pour son usage prévu. Tout ce qui n'est pas sur cette liste devient un candidat au refus par défaut.
Étape 2, choisir où vous voulez que le contrôle s'applique. Si votre équipe a des règles métier très spécifiques à encoder (interdire certaines commandes, valider certains types de fichiers), un harness applicatif comme Claude Code donnera plus de latitude. Si vous voulez une garantie technique qui ne dépend pas de la qualité des règles écrites, un harness à sandboxing natif comme Codex réduit la marge d'erreur humaine.
Étape 3, partir d'une politique restrictive, puis l'ouvrir. Configurez d'abord un accès en lecture seule ou un périmètre de fichiers minimal, testez le workflow réel de l'équipe, puis élargissez précisément ce qui manque plutôt que de partir d'un accès large qu'on referme après coup.
Étape 4, tester en environnement isolé avant tout déploiement. Un dépôt de test ou un conteneur jetable permet de vérifier qu'une règle de refus fonctionne réellement, avant de la valider sur un dépôt de production.
Étape 5, mettre en place une piste d'audit exploitable. Journalisez au minimum les commandes exécutées et les refus déclenchés. Sans cette trace, un incident ne peut pas être diagnostiqué après coup, seulement constaté.
Étape 6, nommer un responsable de la politique. Une politique de permissions qui n'a pas de propriétaire clair dérive avec le temps, au gré des exceptions ajoutées sous pression pour débloquer une tâche urgente.
Pourquoi la sécurité du harness IA compte plus que le benchmark du modèle
Quand une équipe évalue un outil d'agent de code, la tentation est de comparer les scores de benchmark des modèles disponibles. C'est la mauvaise question pour un déploiement en entreprise. Le même modèle, branché sur un harness mal configuré, peut supprimer des données ou exposer des secrets ; branché sur un harness bien gouverné, il ne le peut structurellement pas, quelle que soit la qualité de sa réponse.
C'est le même principe que je détaille dans sécurité des agents IA : ce qui protège réellement, où les permissions et l'isolement comptent plus que n'importe quel produit de supervision. Cette distinction rejoint aussi ce que je développais dans vibe coding contre ingénierie agentique : la mesure qui sépare les deux pratiques n'est pas la puissance du modèle utilisé, mais la discipline mise autour de lui. C'est aussi le même type de question de gouvernance que je retrouve régulièrement en cadrage de mission, notamment sur les pilotes d'agents IA en entreprise, où l'absence de critère de sortie défini à l'avance est la cause la plus fréquente d'échec. Un harness sans politique explicite est le même problème transposé au niveau technique : personne n'a décidé, avant le premier incident, ce que l'agent avait le droit de faire seul.
Erreurs courantes à éviter
Accorder un accès large "pour ne pas être bloqué", puis ne jamais revenir le restreindre une fois le pilote terminé. Écrire des règles de refus fondées sur des mots-clés faciles à contourner par reformulation, plutôt que sur des permissions structurelles. Déployer le même harness et la même politique pour tous les usages, alors qu'un agent qui touche à la production mérite une politique plus stricte qu'un agent qui explore un dépôt de démonstration. Confondre l'absence d'incident avec l'absence de risque : un harness mal gouverné qui n'a encore rien cassé n'a pas encore été testé, pas prouvé sûr.
Ce que je retiens
Le modèle change tous les trois mois. Le harness, lui, reste en place des mois voire des années, et c'est lui qui porte la responsabilité opérationnelle réelle. Évaluer un agent de code sur son seul score de benchmark, sans regarder où et comment sa politique d'exécution est appliquée, revient à choisir une voiture sur la puissance du moteur sans vérifier si elle a des freins. C'est ce diagnostic que j'applique dans mes missions d'intégration IA : le choix du harness et de sa politique de permissions précède toujours celui du modèle, jamais l'inverse.
Questions fréquentes
Qu'est-ce qu'un harness IA, concrètement ?
C'est le système logiciel qui entoure un modèle de langage pour le transformer en agent capable d'agir : gestion des outils, de la mémoire, de la boucle d'exécution sur plusieurs étapes, et des règles de permission. Claude Code, Codex et Cursor sont des harnesses, pas des modèles.
Claude Code et Codex utilisent-ils la même approche de sécurité ?
Non. Claude Code applique sa politique dans l'application elle-même via un système de hooks programmables, avec 31 événements de cycle de vie disponibles. Codex applique la sienne au niveau du système d'exploitation, via un bac à sable natif par plateforme qui restreint réseau et fichiers par défaut.
Quel harness choisir pour débuter en entreprise ?
Codex, avec sa politique `workspace-write` et son accès réseau désactivé par défaut, demande moins de configuration initiale pour obtenir une garantie solide. Claude Code demande d'écrire ses propres règles, mais permet ensuite une personnalisation plus fine, utile dès que les besoins métier deviennent spécifiques.
Faut-il changer de harness à chaque nouveau modèle plus performant ?
Non, et c'est justement l'erreur à éviter. Le harness porte la gouvernance et l'intégration avec les outils de l'équipe ; la plupart des harnesses actuels permettent de changer de modèle sous-jacent sans reconstruire cette couche, ce qui doit rester le critère de choix principal plutôt que le classement du modèle du moment.
Un harness open source est-il plus sûr qu'un harness propriétaire ?
Pas automatiquement. L'ouverture du code permet d'auditer comment la politique est appliquée, ce qui est une vraie garantie de transparence. Mais un harness open source mal configuré reste aussi dangereux qu'un harness propriétaire mal configuré : la licence ne remplace jamais une politique de permissions pensée pour votre contexte.
Découvre mes outils
À propos de l'auteur
Delivery Manager à Rennes. Je pilote des projets de transformation digitale, SEO/GEO et accessibilité RGAA pour des clients grands comptes. Ce blog est le reflet de ce que je rencontre sur le terrain.