TypeSafe et son modèle Jev : l'IA qui refuse d'écrire, et ce que ses chiffres ne disent pas
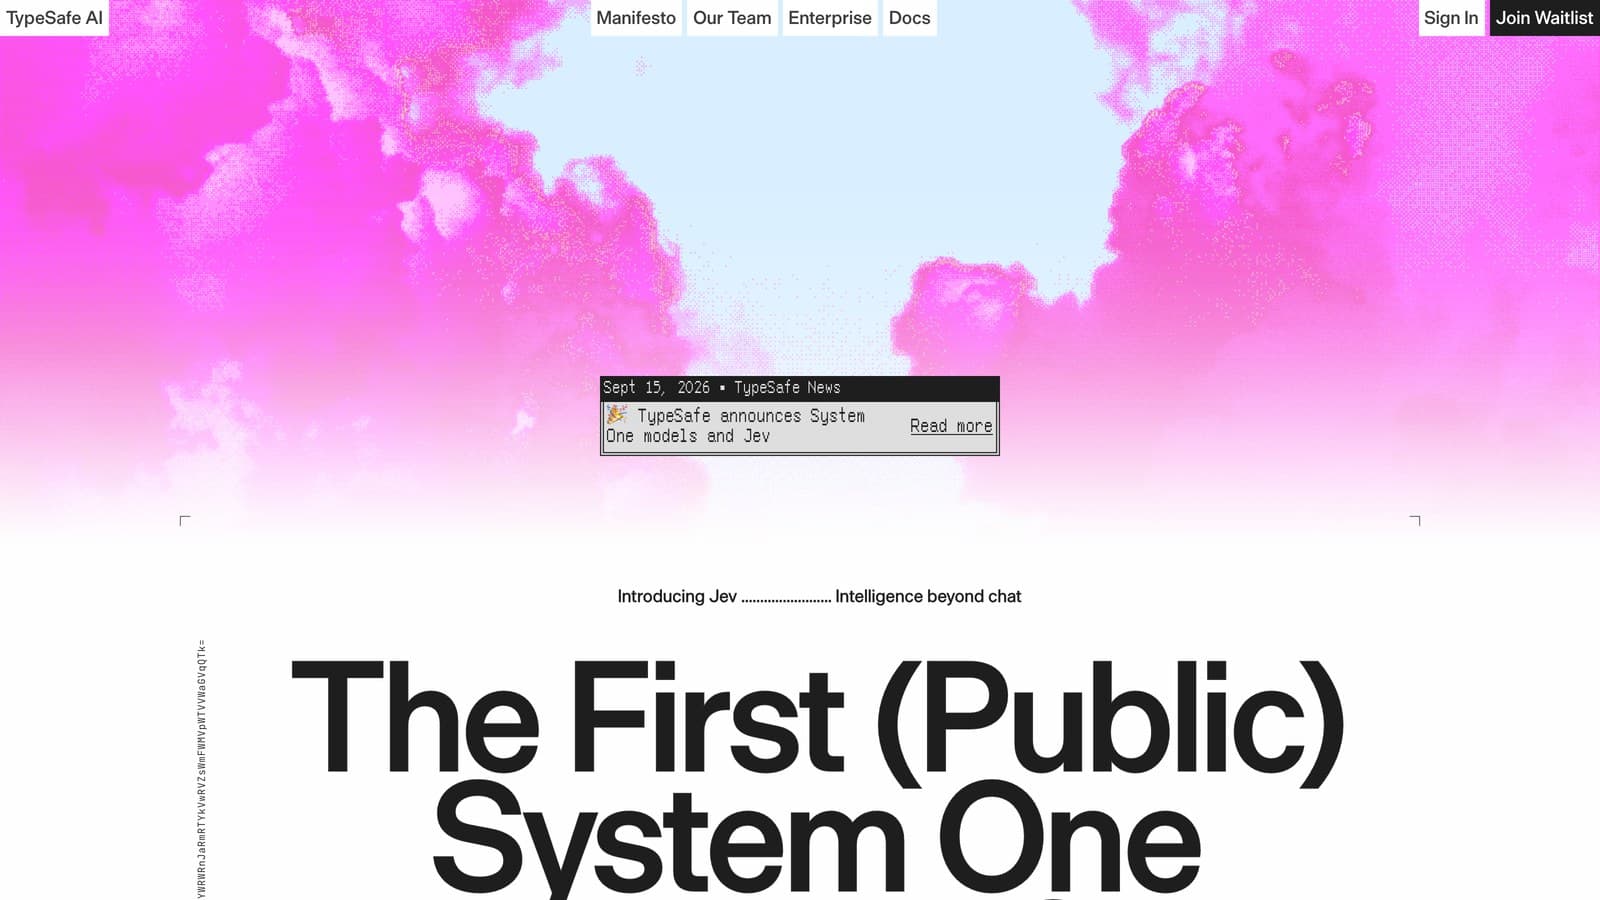

Depuis quelques jours, un nom revient en boucle sur X : Jev, le modèle de TypeSafe. L'argument qui circule tient en une phrase : ce n'est pas un chatbot, c'est une IA qui refuse d'écrire. La formule est bonne et l'idée derrière est sérieuse. Les chiffres qui l'accompagnent demandent plus de prudence, et je vais expliquer pourquoi.
Précision d'entrée : je n'ai pas testé Jev, qui est en accès anticipé. Ce qui suit repose sur les publications de TypeSafe, sur la couverture presse et sur les démonstrations partagées publiquement.
Ce qu'est TypeSafe, et ce qu'est Jev
TypeSafe AI est sortie de stealth mi-septembre 2026 avec un tour d'amorçage de 40 millions de dollars mené par DCVC. L'entreprise est fondée par Diogo Almeida, accompagné d'Erik Gafni et Sasha Sheng.
Un mot sur le pedigree du fondateur, parce qu'il circule sous une forme approximative. Almeida est co-auteur d'InstructGPT, l'article de 2022 qui a appliqué l'apprentissage par renforcement à partir de retours humains aux modèles de langage, et co-auteur du rapport technique de GPT-4. C'est un CV considérable. En revanche, le RLHF lui-même ne date pas de là : il vient des travaux de Christiano et de ses coauteurs en 2017, sur des agents jouant à des jeux Atari, cinq ans plus tôt. Dire qu'il a co-inventé InstructGPT est exact. Dire qu'il a co-inventé le RLHF ne l'est pas.
Leur produit, Jev, est présenté comme un « System One model ». Vous lui donnez un état non structuré, un mail, un DOM, un flux de prix, un paquet de messages, et une question fermée. Il renvoie une valeur typée avec une probabilité collée dessus. Pas de paragraphe à relire, pas de JSON à rattraper.
Le principe : une décision typée plutôt qu'un texte
La différence d'architecture est réelle. Un modèle de langage produit des tokens un par un, chacun dépendant des précédents, ce qui impose une génération séquentielle. TypeSafe annonce au contraire une passe unique et parallèle, avec une méthode d'entraînement qu'ils nomment RLCD, pour apprentissage par renforcement orienté vers des décisions calibrées.
Concrètement, Jev répond à des questions fermées : un choix parmi une liste, un score, un booléen calibré. La cardinalité maximale annoncée est de 255 options. Sur un mail de réclamation, la sortie ne ressemble pas à un résumé mais à quelque chose comme facturation à 0,91 et urgent à 0,96, que le logiciel appelant peut router sans interprétation.
Le problème visé existe, et je le rencontre régulièrement. Quand un traitement a besoin d'une case cochée mille fois par minute, faire produire une phrase par un modèle de frontière puis la parser est coûteux, lent et fragile. C'est exactement le genre de friction que je décris à propos du harnais qui entoure un modèle : une grande partie de la valeur se joue dans la plomberie, pas dans la taille du modèle.
À quoi sert Jev concrètement : le cas du SEO
Tout ceci reste abstrait tant qu'on ne voit pas ce qu'on en ferait un lundi matin. Je prends le SEO parce que c'est mon métier et que les exemples y sont faciles à vérifier.
Imaginez un export de trois mille requêtes sorties de la Search Console. Les questions qu'on se pose dessus sont presque toutes des questions fermées, et c'est précisément là que ce type de modèle se place.
Quelle intention se cache derrière cette requête ? Informationnelle, commerciale, transactionnelle, navigationnelle, locale, comparative. La réponse commande le type de page à produire. Aujourd'hui, soit on trie à la main, soit on interroge un modèle de langage qui répond par un paragraphe qu'il faut relire puis découper.
Vers quelle page existante doit pointer ce mot-clé ? On fournit la requête et la liste des URL du site, et on demande laquelle est la bonne destination. C'est nettement plus sûr que de laisser un modèle génératif proposer une adresse, exercice où il invente volontiers des pages qui n'existent pas.
Ces deux pages se cannibalisent-elles ? Autrement dit, visent-elles la même intention. La question est sémantique et non lexicale : deux pages peuvent se concurrencer sans partager un seul mot de titre.
Cette requête exige-t-elle du contenu frais ? Un tarif, une version logicielle, un texte de loi, une statistique. La réponse détermine la fréquence de révision de la page.
Sur mon propre site, ces questions n'ont rien de théorique. Avec plus de cent articles et vingt-six pages de villes, savoir quelle page doit capter quelle requête, et repérer celles qui se marchent dessus, est un travail de tri répétitif à réponse fermée. C'est aussi exactement la frontière que je décris dans où s'arrête l'automatisation en SEO : le tri s'automatise, l'arbitrage éditorial non. Savoir qu'une requête est transactionnelle ne dit pas s'il faut écrire la page.
Au-delà du SEO : partout où il faut trier
La forme se retrouve dans quantité de métiers, et la documentation de TypeSafe en recense plusieurs familles.
Le classement d'abord : ranger un ticket de support par produit, par type de problème et par intention du client, trier des contrats, catégoriser des déclarations de sinistre. Un dossier arrive, il doit tomber dans la bonne case.
La détection ensuite, qui renvoie une probabilité plutôt qu'une case : ce message est-il du spam, cette demande est-elle urgente, cette opération ressemble-t-elle à une fraude, ce client est-il sur le point de partir. On ne cherche pas une catégorie, on cherche un degré de soupçon, et on fixe un seuil.
Le routage enfin : envoyer un lead au bon commercial, une candidature au bon recruteur, une demande au bon service. Y compris router vers un autre modèle, ce qui rejoint la cascade dont je parle plus bas.
Le point commun de tous ces cas tient en une phrase : la réponse attendue tient dans une liste connue d'avance. Dès qu'il faut rédiger, expliquer ou nuancer, on sort du domaine et on revient à un modèle de langage.
Et si ma liste dépasse 255 options ?
C'est l'objection immédiate dès qu'on parle d'un vrai catalogue produit ou d'une nomenclature métier, et elle a une réponse documentée. TypeSafe recommande de procéder en deux temps plutôt qu'en un seul choix géant : on filtre ou on note d'abord les candidats, puis on tranche parmi les quelques meilleurs. Pour une arborescence profonde, leur mode d'emploi procède par étages successifs, en gardant à chaque niveau une poignée de branches plausibles avant de descendre.
Un conseil de leur documentation mérite d'être retenu par quiconque a déjà construit une taxonomie : prévoir systématiquement une option « autre » ou « aucune de ces réponses ». Sans elle, un modèle contraint de choisir choisira, y compris quand rien ne convient, et l'erreur sera invisible puisque la sortie restera parfaitement valide.
Les chiffres annoncés, et qui les a produits
TypeSafe communique des écarts spectaculaires. Un temps de réponse de bout en bout de 70 à 500 millisecondes, contre 3 à 329 secondes pour les modèles de frontière sur les mêmes tâches. Un gain de 40 à 200 fois en vitesse à intelligence comparable, avec une pointe annoncée à 193,6 fois plus rapide et 444,6 fois moins cher. Côté tarif, 42 dollars le milliard de tokens d'entrée, et une sortie gratuite, ce qui est cohérent puisqu'il n'y a pas de texte à facturer.
Trois réserves s'imposent, et la première vient de TypeSafe elle-même.
L'entreprise précise que les tâches d'évaluation ont été conçues par sa propre équipe, qu'un biais est donc possible, et que les gains mesurés se situent probablement dans le haut de la fourchette de ce qu'on observerait en production. Cette franchise est rare et mérite d'être saluée. Elle invite aussi à lire les chiffres pour ce qu'ils sont : des résultats auto-déclarés, sans audit indépendant, et sans benchmark public standard.
La deuxième réserve est plus sérieuse, et c'est The Register qui la pointe. Les réponses de référence utilisées pour juger Jev proviennent de la moyenne des sorties de GPT-6 Astra et de Claude Fable 5.1, et non d'une vérité terrain établie indépendamment. Ce détail change la nature de l'affirmation. « Intelligence comparable, 193 fois plus vite » devient en réalité « tombe souvent d'accord avec ces modèles, beaucoup plus vite ». C'est déjà utile, mais ça plafonne mécaniquement la qualité mesurée à celle des modèles servant de référence, et ça ne dit rien des cas où ces derniers se trompent ensemble.
La troisième porte sur le mot hallucination. TypeSafe annonce zéro hallucination. La garantie réelle est qu'un schéma empêche une sortie malformée, ce qui est appréciable et ne signifie pas que la réponse est juste. Un modèle qui renvoie toujours une valeur valide peut renvoyer la mauvaise valeur, avec une probabilité confiante dessus. La comparaison avec les hallucinations d'un modèle de langage n'est d'ailleurs pas équivalente, puisque la sortie n'est pas du langage naturel.
Ce que les démonstrations montrent, et ce qu'elles ne montrent pas
Les démonstrations publiées depuis le lancement sont impressionnantes et vont dans tous les sens : pilotage d'un navigateur à la voix avec des réponses autour de 300 millisecondes, classification de plusieurs centaines de publicités pour quelques centimes, analyse de milliers de publications, bot de trading branché sur un flux de prix, compaction de contexte d'une session longue.
Ces retours viennent d'utilisateurs, sur leurs propres jeux de données, sans protocole partagé. Ils témoignent d'un enthousiasme réel et d'une latence qui semble tenir ses promesses. Ils ne constituent pas une mesure de justesse, parce que presque aucun ne compare les décisions de Jev à une vérité connue. Classer 1 891 publicités en 19 secondes est un fait vérifiable. Les avoir bien classées est une autre affirmation, qui demande un corpus annoté.
Le cas d'usage qui me paraît le plus solide
Derrière toutes ces démos, une idée ressort et me semble la plus durable : la cascade. Faire trancher les cas évidents par un modèle rapide et bon marché, qui annonce honnêtement son niveau de confiance, et n'escalader vers un modèle de frontière que les cas incertains.
Sur un flux de tickets, de factures ou de mails, une part significative des décisions est triviale. Les envoyer toutes à un modèle coûteux revient à payer le tarif du cas difficile pour traiter le cas facile. C'est le même raisonnement économique que celui que j'applique à la tarification des appels d'API selon les heures : ce qui compte n'est pas le prix affiché au million de tokens, c'est le coût du travail réellement accompli.
Cette architecture n'a rien de nouveau, c'est du routage à seuil de confiance, une pratique ancienne en apprentissage automatique. Sa valeur ici ne dépend d'ailleurs pas du fait que Jev soit 193 fois plus rapide que quoi que ce soit. Elle dépend d'une seule chose : que la probabilité renvoyée soit réellement calibrée, c'est-à-dire qu'une confiance annoncée à 0,9 corresponde bien à neuf bonnes réponses sur dix. C'est le point à tester en premier avant d'industrialiser quoi que ce soit.
Ce que je retiens
L'idée est bonne et le besoin est réel. Traiter une décision comme une primitive typée plutôt que comme un paragraphe à interpréter va dans le bon sens, et l'équipe qui la porte a une crédibilité technique sérieuse.
Mais l'affirmation qui fait le tour de X, celle d'une intelligence équivalente pour deux cents fois moins cher, repose aujourd'hui sur des évaluations produites par l'éditeur, jugées contre des réponses générées par les concurrents. Ce n'est pas un procès d'intention, c'est un constat de méthode, et TypeSafe en reconnaît une partie.
C'est le même réflexe que celui que j'applique à toute annonce qu'aucun critère ne permet de vérifier : la question utile n'est pas de savoir si l'affirmation est vraie, c'est de savoir ce qui permettrait de la départager. Ici, la réponse est simple et à portée de main de quiconque a un jeu de données annoté : mesurer la justesse et la calibration sur son propre corpus, pas sur celui de l'éditeur.
Si vous évaluez Jev pour un usage réel, c'est par là que je commencerais, avant de regarder la latence. Et c'est le type d'arbitrage que j'accompagne dans mes missions d'intégration IA.
Sources : TypeSafe AI, Introducing System One Models & Jev ; The Register, TypeSafe AI debuts model for machines that plays Doom, 16 septembre 2026 ; Ouyang et al., Training language models to follow instructions with human feedback, 2022 ; Christiano et al., Deep Reinforcement Learning from Human Preferences, 2017 ; Wilson Sonsini, conseil de TypeSafe AI sur son tour d'amorçage de 40 millions de dollars ; fil de Brivael Le Pogam sur X, 18 septembre 2026 ; TypeSafe AI, les cas d'usage documentés ; TypeSafe AI, classification hiérarchique ; Violetta Bonenkamp, les cas d'usage SEO de Jev.
Questions fréquentes
Jev remplace-t-il un modèle de langage ?
Non, et TypeSafe ne le prétend pas. Jev ne produit pas de texte : il tranche des questions fermées. Rédiger, résumer, raisonner longuement restent du ressort des modèles de langage. Les deux se combinent plutôt qu'ils ne se substituent, le modèle rapide filtrant ce qui n'a pas besoin du modèle coûteux.
Que vaut la promesse de zéro hallucination ?
Elle porte sur la forme, pas sur le fond. Le schéma garantit une sortie valide, jamais une sortie juste. Un mauvais choix parmi des options valides reste possible, avec une probabilité élevée affichée. Il faut donc mesurer le taux d'erreur sur ses propres données plutôt que se fier à la formule.
Le prix de 42 dollars le milliard de tokens est-il comparable à celui d'un LLM ?
Pas directement. Seule l'entrée est facturée, la sortie étant annoncée gratuite, et le volume de tokens consommé pour une décision n'a rien à voir avec celui d'une réponse rédigée. La comparaison pertinente se fait au coût par décision sur un volume réel, pas au tarif affiché.
Comment tester sérieusement ce type de modèle ?
Avec un échantillon annoté par des humains, issu de vos propres données, en mesurant deux choses distinctes : le taux de bonnes décisions, et la calibration, c'est-à-dire la correspondance entre la probabilité annoncée et la fréquence réelle de succès. Sans le second, impossible de fixer un seuil d'escalade fiable.
Découvre mes outils
À propos de l'auteur
Delivery Manager à Rennes. Je pilote des projets de transformation digitale, SEO/GEO et accessibilité RGAA pour des clients grands comptes. Ce blog est le reflet de ce que je rencontre sur le terrain.